
Nvidia acaba de darle un empujón bastante fuerte a sus sistemas locales de inteligencia artificial DGX Spark, enfocándose tanto en la potencia de procesamiento como en la capacidad de memoria que tienen los desarrolladores en su día a día.
Nvidia DGX Spark ahora puede escalar a 8 unidades
La novedad más llamativa es que las unidades DGX Spark ahora permiten crear clústeres de hasta ocho equipos, elevando el almacenamiento unificado hasta 1 TB completo en las configuraciones más avanzadas.
Poder juntar tantas máquinas de forma local cambia por completo el panorama para quienes trabajan con modelos complejos de lenguaje y agentes de IA, siempre que tenga el presupuesto para invertir en estos equipos.
Antes el límite estaba en cuatro unidades, pero duplicar esta cifra significa que ahora es posible ejecutar modelos de gran escala con suficiente margen de memoria libre para mantener contextos largos, historiales amplios y herramientas de desarrollo distribuidas sin depender de servidores externos.
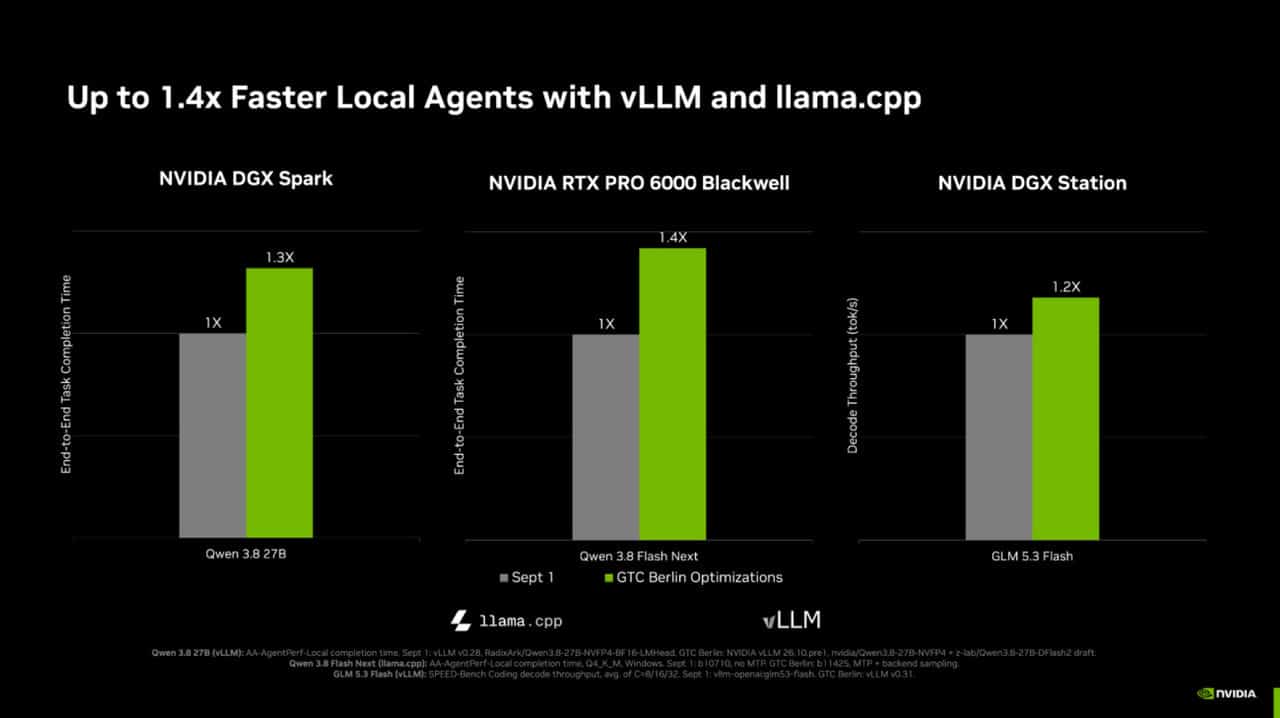
Además del salto evidente en hardware, la compañía metió mano en la parte de software trabajando junto con las comunidades de código abierto de vLLM y llama.cpp. Gracias a estas optimizaciones, las tareas de inferencia muestran mejoras notables que rondan entre el 20 y el 40% por ciento de velocidad según el equipo que se utilice. Esto se traduce en interacciones mucho más fluidas al probar código, generar contenido o correr asistentes automatizados en el propio escritorio.
Te recomendamos nuestra guía sobre los mejores Mini PCs del mercado
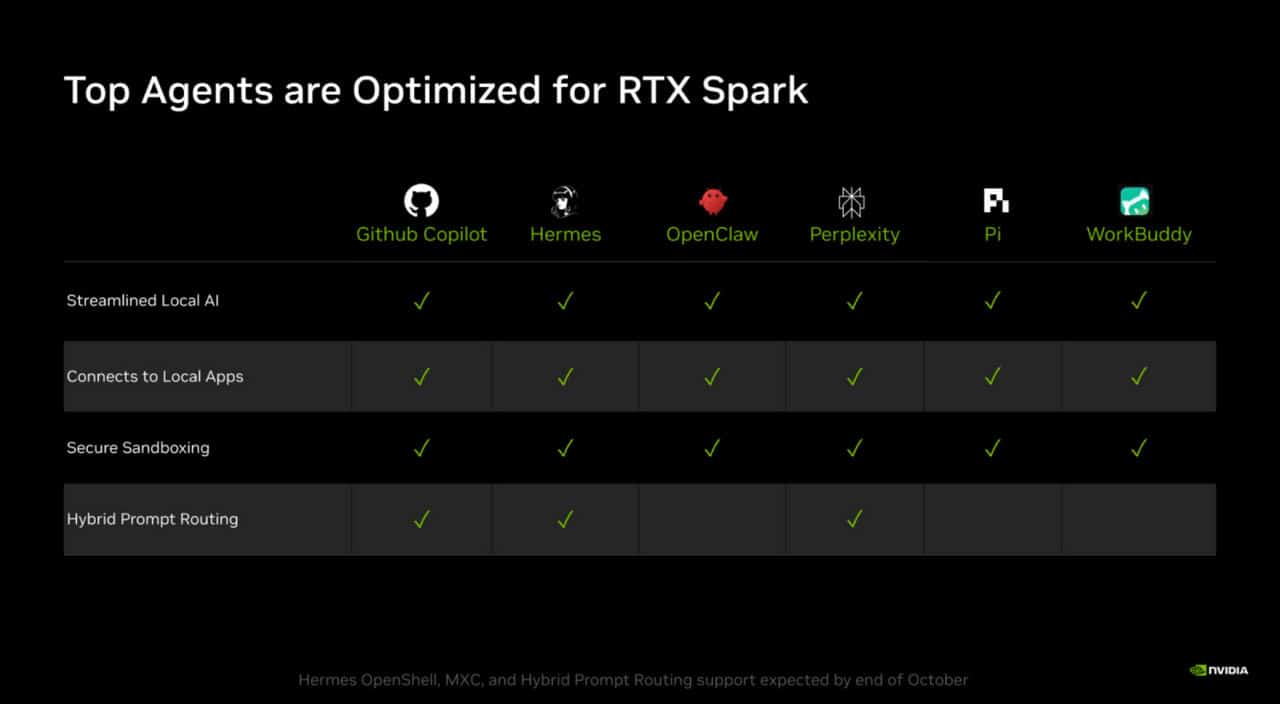
Para hacerle la vida más fácil a quien está programando, la compañía también sumó herramientas como el Nvidia Sync Model Launcher. Este sistema simplifica muchísimo la descarga de modelos y su vinculación directa con plataformas de desarrollo, quitando de en medio la parte tediosa de la configuración manual. A esto se le suman actualizaciones de software que incluyen asistentes de red y guías de mantenimiento integradas.
En definitiva, estos cambios buscan que trabajar con inteligencia artificial de nivel avanzado de manera local sea algo práctico y accesible. Al final del día, tener más memoria disponible, un mejor rendimiento en las consultas y una gestión más sencilla de los modelos permite que cualquier equipo de trabajo avance mucho más rápido en sus proyectos diarios.